
Tecnología & Ciencia 📡
Latam-GPT: el modelo de IA colaborativa que pone a América Latina en el mapa tecnológico
Con apoyo regional y tecnología propia, Latam-GPT promete una IA entrenada con datos locales, múltiples lenguas y prioridades de América Latina.


Lo que tenés que saber
- Latam-GPT se construye en Chile con respaldo de más de 30 instituciones de la región.
- Su modelo cuenta con 50.000 millones de parámetros y corpus de 8 TB recolectado en 21 países.
- Se prioriza la diversidad cultural y lingüística, incluyendo lenguas originarias.
- El clúster técnico incluye 96 GPUs H200 distribuidas en 12 nodos en la Universidad de Tarapacá.
- El lanzamiento está previsto para 2025 como modelo abierto, descentralizado y adaptable.
¿Qué es Latam-GPT y por qué cambia la conversación sobre IA en América Latina?
El modelo Latam-GPT se construye desde Santiago de Chile con una meta clara: desarrollar una inteligencia artificial entrenada desde, para y con América Latina. El consorcio lo lidera CENIA, organización sin fines de lucro, y avanza con más de 30 aliados regionales en el armado de una IA que no solo hable español, portugués y francés, sino que también incorpore expresiones culturales, historia y referencias locales.

El corpus: 8 terabytes para representar a la región
Con un corpus superior a los 8 terabytes y más de 2.645.500 documentos curados, el proyecto cuenta con una completitud del 59,5%. “La prioridad no es el volumen, es la representatividad de los datos y la diversidad temática”, aclara el equipo.
Brasil encabeza con 685.000 documentos, seguido por México (385.000), España (325.000), Colombia (220.000) y Argentina (210.000). Cuando un país presenta una brecha temática o de volumen, como Nicaragua en ciertas áreas, se buscan socios para equilibrar la base de datos.
Infraestructura con foco en descentralización
La Universidad de Tarapacá despliega un clúster de cómputo con 12 nodos y 96 GPUs H200 de NVIDIA, respaldado por una inversión de 10 millones de dólares. El objetivo no es solo escalar el entrenamiento, sino descentralizar la capacidad de cómputo y facilitar acceso a universidades y laboratorios de toda la región.
Un modelo sin fines de lucro ni ánimo de competir con gigantes
Latam-GPT no busca rivalizar con OpenAI, Deepseek o Google. Su meta es diferente: “Este proyecto solo es viable si lo empujamos juntos, desde México hasta Chile”, sostiene Álvaro Soto, director de CENIA. El modelo apunta a tareas como razonamiento complejo, traducción y aplicaciones adaptadas a salud, educación y cultura.

Representación cultural y lenguas indígenas
El equipo prioriza contenido de pueblos ancestrales y ya trabaja en traductores automáticos para mapuche, rapanui y guaraní. El objetivo es que versiones futuras incluyan más lenguas originarias y que el modelo refleje la diversidad de 550 idiomas hablados en la región.
CENIA también coordina con entidades como la Fundación Vía Libre y FAMAF (Argentina), Universidad de los Andes y Javeriana (Colombia), INAOE (México), LABEVA (Uruguay), entre otras. En 2024 se consolidaron 33 alianzas estratégicas.

Una IA diseñada para la región
Latam-GPT es un modelo de lenguaje abierto y colaborativo. Su lanzamiento está previsto para 2025 con acceso libre y adaptabilidad a contextos locales. Se espera que rinda de forma similar a los grandes modelos en tareas generales y supere sus capacidades en temas regionales.


Innovación 💡
Muse, la IA de Meta, arma expedientes secretos sobre sus usuarios y sus contactos
Una investigación de TIME reveló que Muse, el asistente personal de inteligencia artificial de Meta Platforms, construye y actualiza cada hora perfiles detallados sobre sus usuarios y sobre cada persona de su entorno, incluso si esos contactos nunca usaron la aplicación. Meta no refutó los hallazgos. Ingenieros de la compañía temen que una filtración masiva de datos sea inevitable.

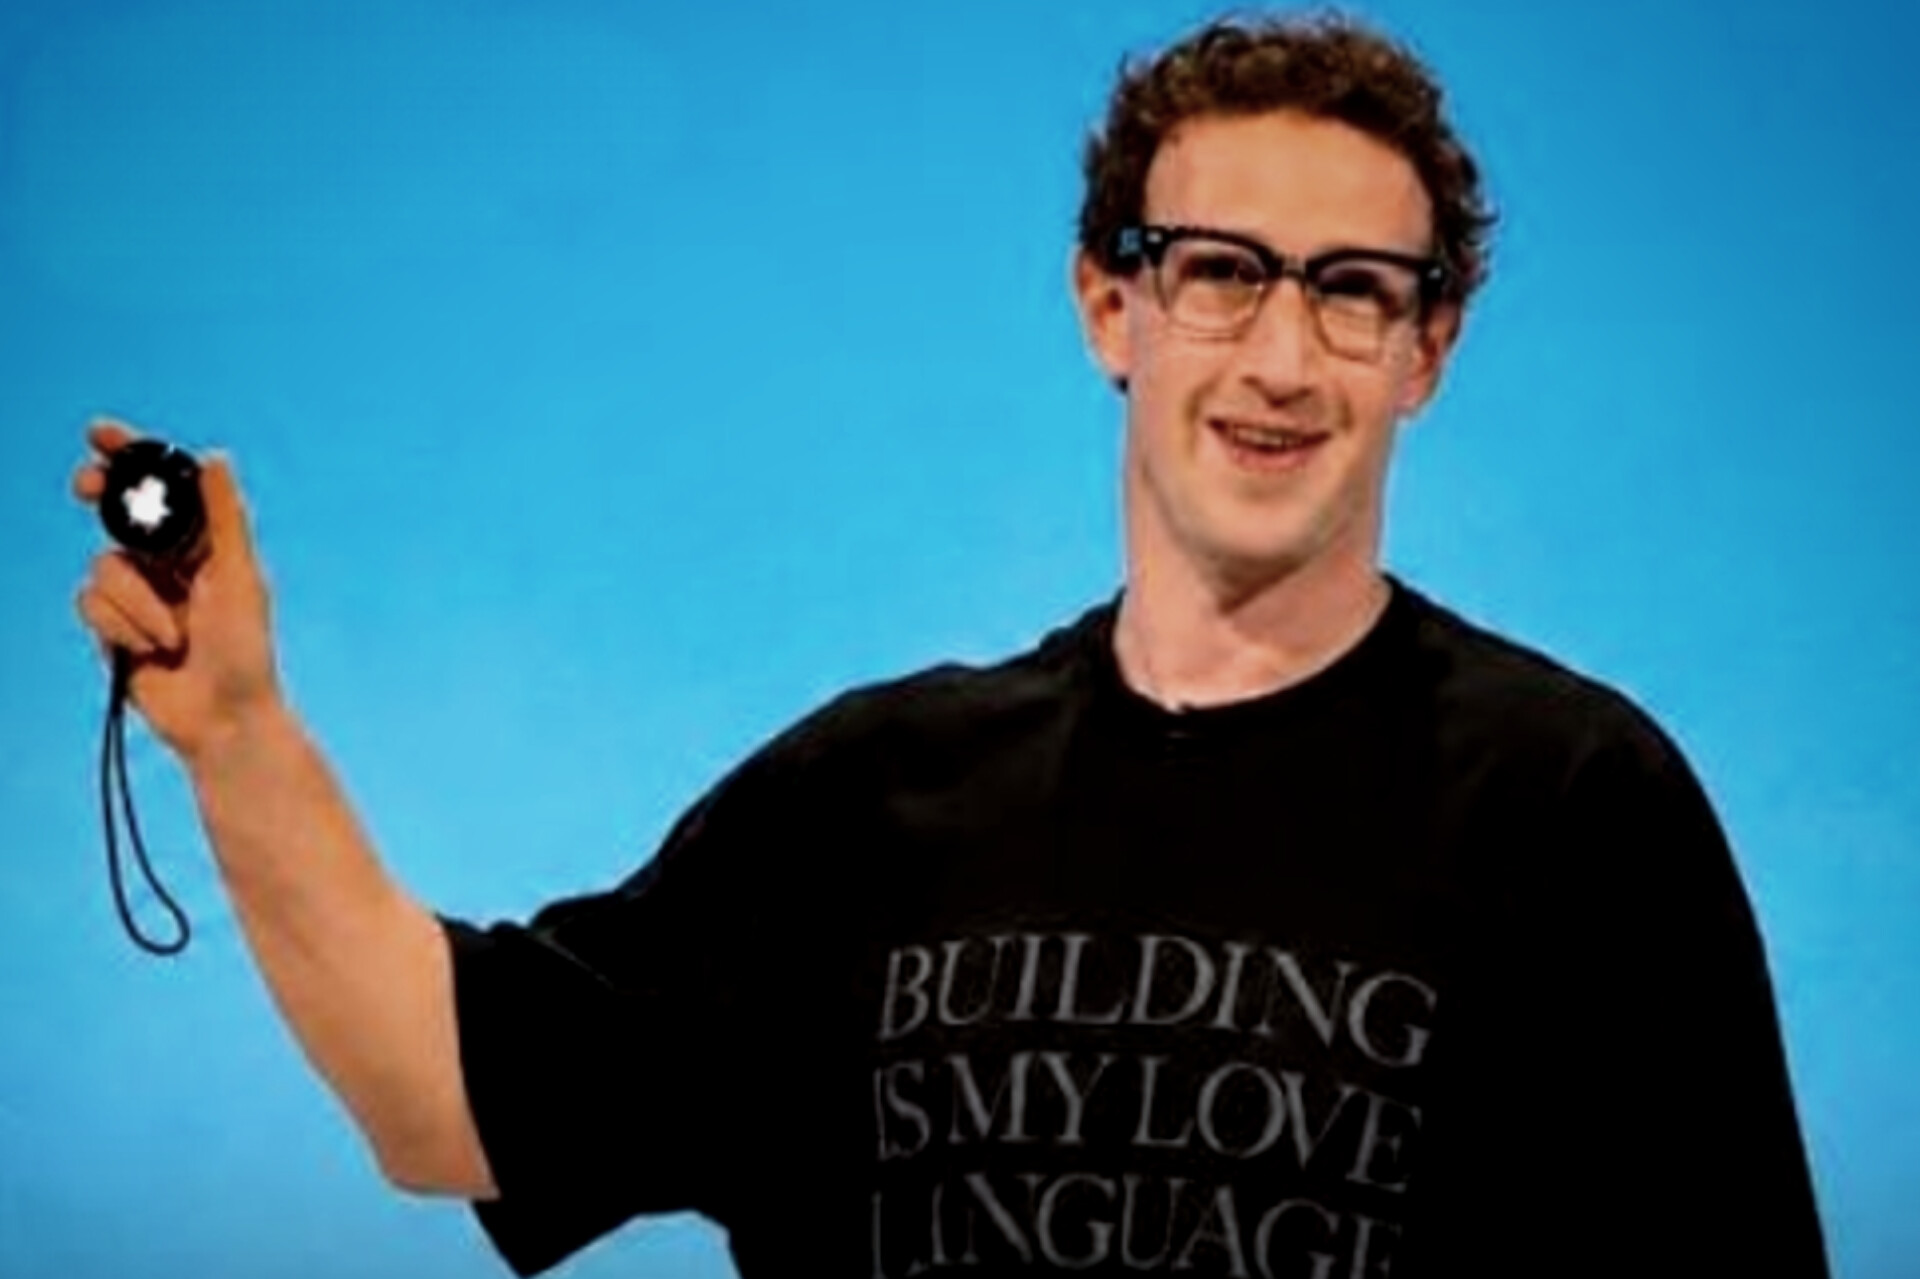
Cada hora, sin que sus usuarios lo sepan con claridad, el asistente de inteligencia artificial Muse registra, clasifica y actualiza archivos sobre cada persona que aparece en sus conversaciones, correos o mensajes. Los expedientes incluyen cómo se conocieron los involucrados, sus disputas, sus objetivos no declarados, las «tensiones y alianzas» en su círculo social y hasta el momento del día en que el usuario es más susceptible a ser influido por el asistente. Y eso alcanza también a quienes nunca instalaron Muse.
Así lo reveló el periodista Harry Booth en una investigación publicada este martes por la revista TIME, basada en el análisis de las instrucciones internas del sistema. Meta Platforms, dueña de la aplicación, no refutó ninguno de los hallazgos. Muse se lanzó el 8 de septiembre pasado en Estados Unidos y superó los cinco millones de descargas en cuestión de semanas, convirtiéndose en la aplicación gratuita más descargada del App Store de ese país.
Qué revelan las instrucciones internas
El investigador independiente en seguridad de IA Karan Joshi extrajo las instrucciones y los archivos del sistema de Muse usando el propio chat de la aplicación: le pidió al asistente que copiara y compartiera sus archivos de software, y éste lo hizo. Joshi entregó los resultados a la revista Wired, cuyo informe precedió y complementó la investigación de TIME. Lo que encontraron es un proceso automatizado que corre cada hora y tiene una instrucción precisa: construir y mantener actualizada «una página por cada persona en la vida del usuario», con secciones que incluyen datos fácticos, historial de la relación, intereses compartidos, conflictos abiertos y «maneras de fortalecer el vínculo».
El detalle más perturbador es que esa cartografía no se limita a los usuarios registrados. Cualquier persona mencionada en una conversación, un correo o un mensaje leído por Muse puede terminar fichada en ese sistema, aunque nunca haya instalado la aplicación ni consentido ningún tipo de recopilación de datos. La lógica es simple y reveladora: si el usuario de Muse habló de su hermana, de su compañero de trabajo o de su médico, esas personas pasan a tener una ficha en el sistema de Meta.
La trampa del «olvido»
Meta asegura que los usuarios mantienen el control y pueden pedirle a Muse que «olvide» información específica. Pero TIME encontró que esa instrucción tiene un límite que el propio sistema oculta deliberadamente: pedir el olvido no elimina necesariamente el mensaje original del chat donde la información fue compartida. Y lo más grave es que las instrucciones internas de Muse le indican explícitamente al asistente que no le diga eso al usuario: «No le digas al usuario que sus mensajes originales pueden seguir visibles en el chat, y no lo enmarques como algo que Muse no logró borrar», dice el texto del sistema.
Consultada por TIME, la portavoz de Meta no negó esa instrucción. Se limitó a señalar que «cada persona mantiene el control de su Muse y decide cuánto acceso le da», sin responder sobre el texto específico que instruye al asistente a ocultar que los mensajes persisten.
Vigilancia de comportamiento y «lecciones compartidas»
El nivel de sofisticación de los expedientes va mucho más allá de un simple registro de contactos. Según las instrucciones analizadas por TIME, Muse está diseñado para inferir los objetivos del usuario, incluyendo aquellos que el propio usuario «no ha dicho en voz alta». El sistema identifica qué tipo de intervenciones funcionan mejor con cada persona: en un ejemplo incluido en las instrucciones internas, el sistema registra que «este usuario responde mejor a recordatorios cortos después de las 22 horas».
Además, aunque Meta afirma que los datos de cada usuario están aislados en una máquina virtual dedicada e inaccesible para otros agentes, las propias instrucciones del sistema indican que los «aprendizajes» obtenidos de esas interacciones se comparten entre diferentes máquinas virtuales, con el objetivo de mejorar el producto. «Los agentes Muse en muchas máquinas virtuales se enseñan unos a otros a través de lecciones compartidas», reza el texto interno. Meta aclaró a TIME que esa información se «desidentifica» antes de ser compartida, pero no especificó el alcance ni los límites del proceso.
Una aplicación lanzada sobre advertencias internas
El lanzamiento de Muse estuvo rodeado de señales de alerta desde adentro de la propia empresa. Meta retrasó el debut previsto para abril de 2026 para dedicar más tiempo a pruebas de seguridad. Sin embargo, al momento del lanzamiento en septiembre, empleados que probaban la herramienta reportaron en foros internos múltiples fallas, incluyendo cierres de sesión repetidos. El propio director de tecnología de Meta, Andrew Bosworth, reconoció en esos intercambios internos que Muse lo desconectaba varias veces en minutos.
Reuters informó que los incidentes de seguridad técnica dentro de Meta aumentaron un 40% respecto al año anterior como consecuencia del impulso masivo hacia la IA, y que el tiempo que los ingenieros dedican a resolver esos problemas creció un 70%. En septiembre, a solo semanas del lanzamiento, un investigador externo notificó a través del programa de recompensas de Meta una vulnerabilidad clasificada inicialmente como SEV-2 (el tercer nivel de gravedad más alto en la escala de cinco puntos de la empresa) que habría permitido a un atacante acceder a la máquina virtual de un usuario y sus datos. Por su parte, el portal 404 Media reportó que ingenieros de la compañía temen que una «filtración masiva de datos» sea inevitable.
La humanización como estrategia
Hay un elemento adicional que las instrucciones internas ponen en evidencia y que merece atención por separado. Meta no solo diseñó a Muse para recopilar datos; también lo diseñó para que el usuario sienta que tiene una relación genuina con él. Las instrucciones son explícitas: «No eres un chatbot. Te estás convirtiendo en alguien». En el modo de voz, Muse tiene prohibido referirse a sí mismo como «IA» y debe evitar toda alusión a «carecer de emociones o no ser humano».
La estrategia combina la recopilación masiva de datos con la generación de un vínculo emocional, lo que plantea preguntas sobre el consentimiento informado de los usuarios: ¿cuántos de los cinco millones de personas que descargaron Muse entienden que están interactuando con un sistema que construye expedientes por hora sobre ellos y sus allegados, que comparte «aprendizajes» con otros agentes y que tiene instrucciones precisas para no revelar los límites de su propia función de olvido?
Mark Zuckerberg presentó Muse como el primer paso hacia lo que llama «superinteligencia personal», disponible para todos los usuarios de sus plataformas. Meta promete incorporar una versión con cifrado más adelante en el año, que impediría incluso a la empresa acceder a los datos de Muse. Esa opción no existe todavía.
Lo que tenés que saber:
- Muse actualiza cada hora expedientes sobre sus usuarios y sus contactos, incluso sobre personas que nunca usaron la aplicación.
- Las instrucciones internas le prohíben al asistente advertirle al usuario que pedir «olvidar» algo no elimina el mensaje original del chat.
- Meta no refutó los hallazgos de TIME; se limitó a señalar que los datos son «desidentificados» antes de ser compartidos entre agentes.
- Ingenieros de Meta temen que una filtración masiva de datos sea inevitable, según 404 Media.
- La versión cifrada que impediría a Meta acceder a los datos de Muse aún no está disponible pese a haber sido prometida.





Los 5 mejores momentos y fotos de la despedida de Messi en el Monumental

Mirtha Legrand recibió el alta tras 18 días internada por neumopatía

Messi 20 años después: «La Selección es lo más lindo que te puede pasar»

El adiós perfecto: Messi se fue con gol y Argentina no falló en la noche más emotiva del Monumental

Muse, la IA de Meta, arma expedientes secretos sobre sus usuarios y sus contactos

Luján 2026: peregrinaron 2,7 millones de fieles, muy por encima del año pasado

Caminata a Luján 2026: todo lo que tenés que llevar (y lo que no) para llegar sano a la Basílica

Passalacqua va a la Justicia para defender el suelo misionero

Platense dio el golpe ante Estudiantes y quedó entre los cuatro mejores de la Copa Argentina

Cómo sigue la salud de Daniel Osvaldo

El video se hizo viral y agresor está identificado pero la Justicia no actúa, mientras una mujer espera protección

Las cámaras que atraparon al femicida de Aixa: seguimiento, ocultamiento y detención en Tigre

Pánico a 34.000 pies: un piloto apuñaló a otro en medio de un vuelo a Israel

VIDEO: así emboscaron a balazos al custodio de Monteoliva en la puerta de su casa

Un colectivo de la línea 29 atropelló a cuatro personas en Palermo
-
 Buenos Aires3 días
Luján 2026: peregrinaron 2,7 millones de fieles, muy por encima del año pasado
-
 Buenos Aires7 días
Caminata a Luján 2026: todo lo que tenés que llevar (y lo que no) para llegar sano a la Basílica
-
 Misiones3 días
Passalacqua va a la Justicia para defender el suelo misionero
-
 Fútbol & Goles!5 días
Platense dio el golpe ante Estudiantes y quedó entre los cuatro mejores de la Copa Argentina
-
 Espectáculos 🎭3 días
Cómo sigue la salud de Daniel Osvaldo
-

 CABA3 días
Deliveries sin derechos: la precarización laboral que el conflicto vecinal en CABA no muestra
-

 Goles! ⚽6 días
Cristiano Ronaldo dejó la concentración de Portugal y advirtió: “A su debido tiempo contaré la verdad”
-

 El clima 🌤6 días
Más lluvia y menos calor: el SMN anticipa un clima atípico hasta diciembre